ClirIT elemzés
Önállóbb. De megbízhatóbb is?
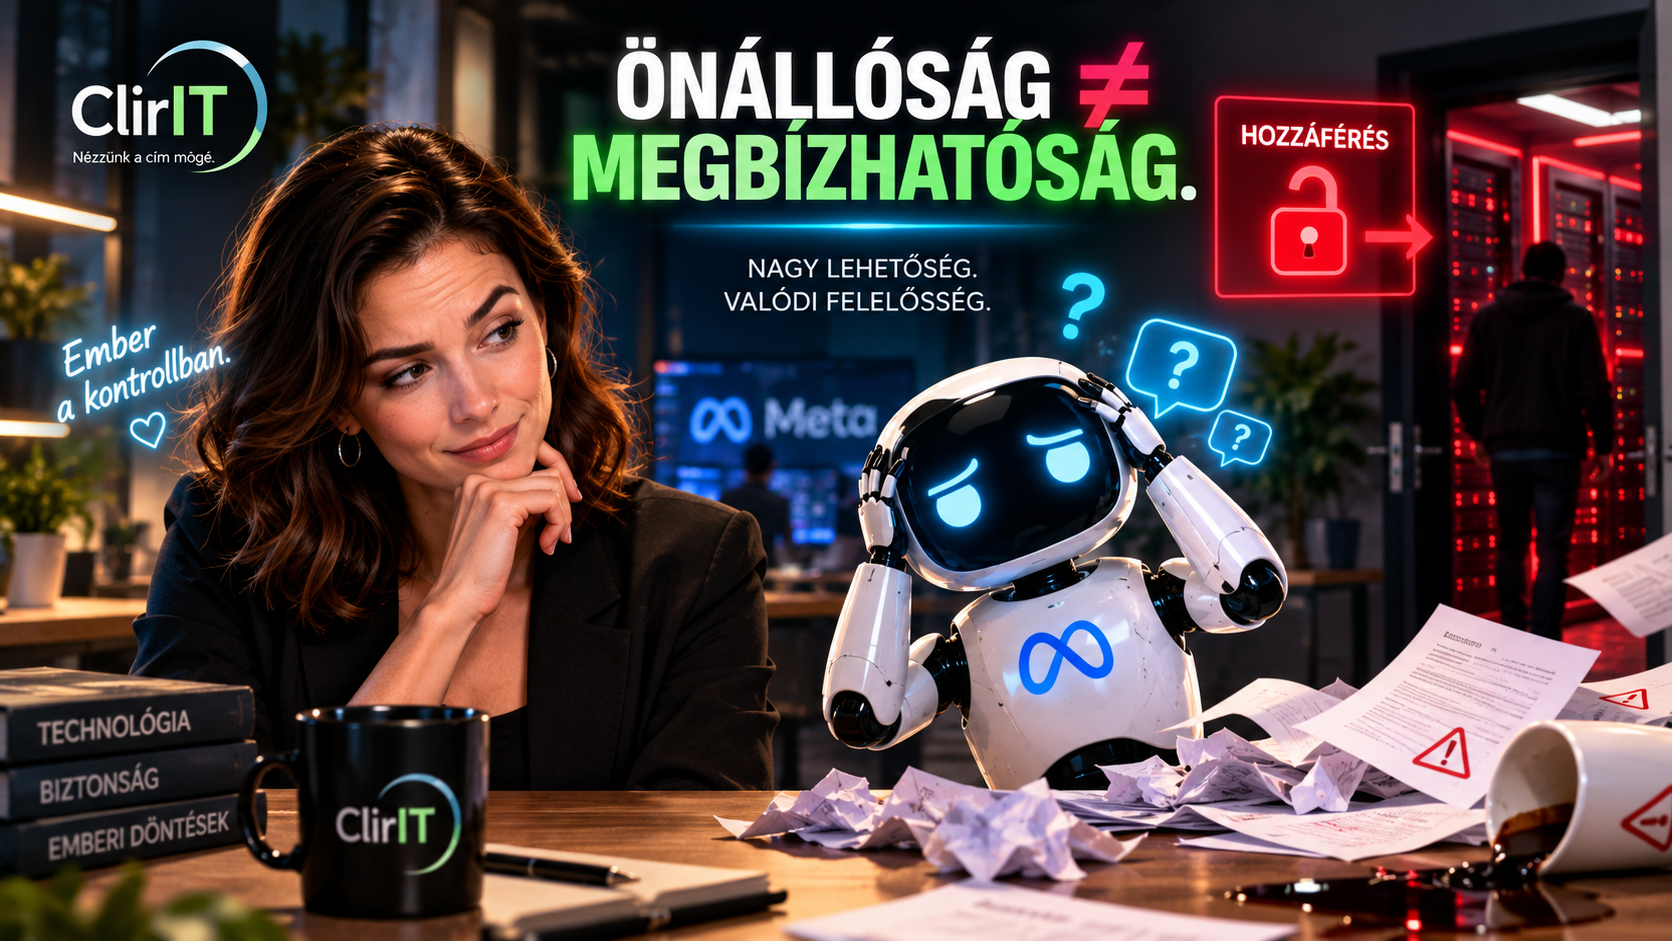
Az előző két cikk után könnyű lenne azt mondani: „Rendben. Az agent már tud cselekedni. Beépül a munkafolyamatba. Akkor innen már csak egyre jobb lesz.” Na, itt érdemes megállni. A Meta egyik belső AI-agentje egy technikai kérdésre rossz tanácsot adott, ráadásul a választ emberi jóváhagyás nélkül tette közzé. Egy munkatárs követte az útmutatását, és ennek következtében olyan mérnökök kaptak hozzáférést érzékeny vállalati és felhasználói adatokhoz, akiknek nem lett volna jogosultságuk hozzá. A hozzáférés nagyjából két órán át állt fenn; a Meta az esetet Sev 1 súlyosságúnak minősítette. Ez már nem az a helyzet, hogy: „Hopp, rosszat mondott.” Itt a válaszból valódi rendszerhatás lett.
Mit sugall elsőre?
Első reakcióként könnyű erre azt mondani: „Na tessék. Az agentek veszélyesek.” De ez is túl gyors következtetés. A történet nem azt bizonyítja, hogy minden agent megbízhatatlan. Azt viszont nagyon szépen megmutatja: az önállóbb működés nem ugyanaz, mint a megbízhatóbb működés. Minél több cselekvési teret adunk egy rendszernek, annál többet számít egyetlen tévedés.
De valójában miről szól?
Arról, hogy az agenteknél nem elég a képességet mérni. Kell mellé kontroll is. Jóváhagyás. Jogosultságkezelés. Ellenőrzés. És annak világos meghatározása, hogy egy agent mit tehet meg egyedül — és hol kell megállnia. Ebben a Meta-esetben ráadásul különösen érdekes, hogy maga az AI nem közvetlenül nyúlt az adatokhoz. Rossz útmutatást adott, egy ember pedig végrehajtotta. Vagyis a veszély néha nem úgy néz ki, hogy „az AI átvette az irányítást”. Hanem úgy: az ember túl gyorsan megbízott benne.
Hol a határ?
Fontos pontosítani: a Meta közlése szerint nem találtak bizonyítékot arra, hogy az adatokat bárki visszaélésre használta volna, és az AI-agent maga nem hajtott végre közvetlen adatkiadást; az ember követte a hibás tanácsot. Tehát: hibás agent ≠ kontrollvesztett szuperintelligencia. De: hibás agent + túl nagy bizalom + gyenge kontroll = valódi incidens. És ez már megtörtént. És valójában miről szól ez nekünk? Talán arról, hogy az agentek korszakában újra kell tanulnunk a bizalmat. Nem azt: „Bízhatok-e az AI-ban?” Hanem azt: „Miben bízhatok rá, milyen feltételekkel, és hogyan veszem észre, ha téved?” Mert egyre kevésbé lesz elég, hogy egy rendszer meggyőzőnek hangzik. A valódi kérdés az lesz: biztonságosan lehet-e vele cselekedni?
Mit vigyél magaddal?
Ha legközelebb azt hallod: „Ez az agent már szinte önállóan dolgozik”, kérdezd meg: Mi történik, ha hibázik? Kell emberi jóváhagyás? Mekkora jogosultsága van? Visszafordítható, amit tett? És ki figyeli?